核心摘要:开源项目 Pipelex 提出了一种“方法与运行面解耦”的工程思路:先用自然语言让编程助手编写确定性的
.mthds多步 AI 工作流,再同一套定义直接暴露为聊天机器人的 MCP 工具、独立 Web 应用、TypeScript/Python SDK 或 HTTP API,并支持托管、自带密钥及本地模型三种推理后端。
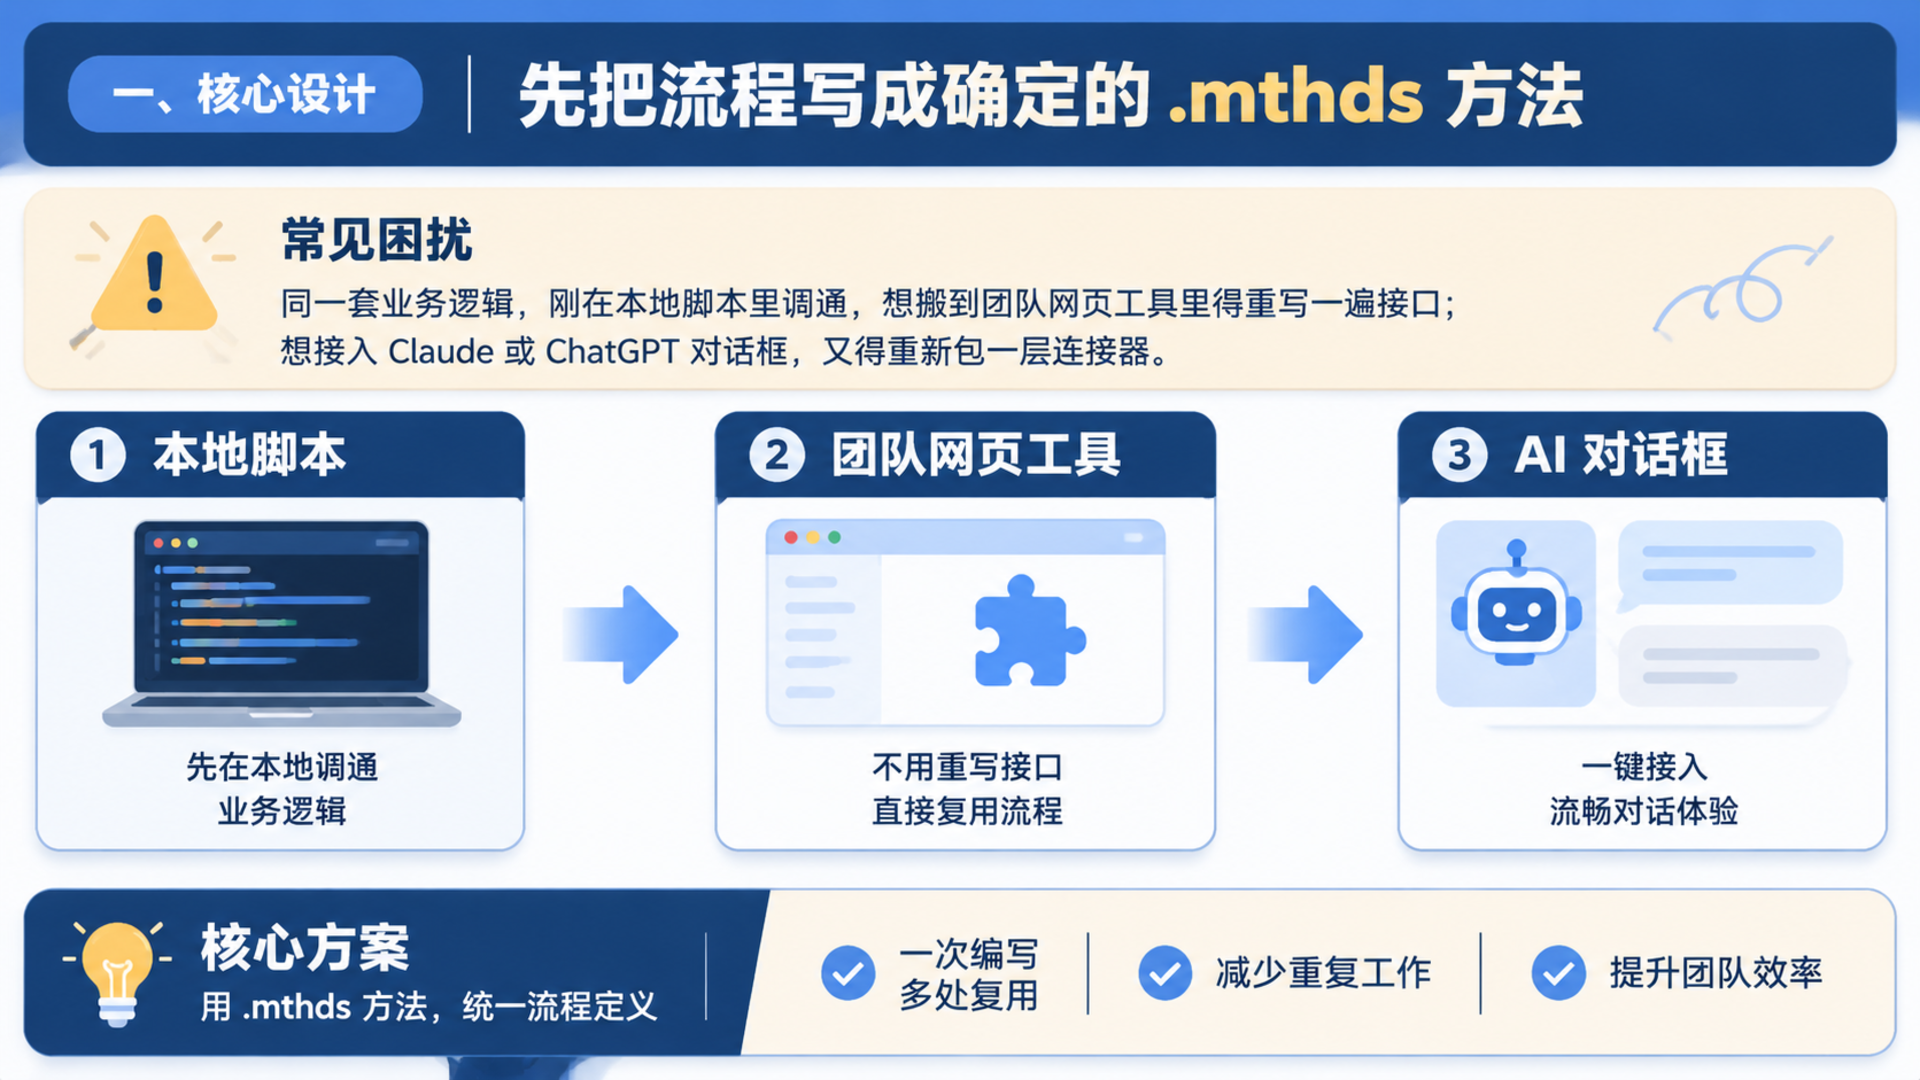
很多团队在尝试 AI 自动化时,最容易卡在一个重复消耗精力的问题上:同一套业务逻辑,刚在本地脚本里调通,想搬到团队网页工具里得重写一遍接口;想接入 Claude 或 ChatGPT 对话框,又得重新包一层连接器。
从我们在 OpenLX 推进企业 AI 部署和可信内容工程的经验来看,这类返工的根源往往不在大模型本身,而在于“业务流程定义”和“外部调用入口”耦合得太紧。近期在 GitHub 公开仓库巡检中看到的开源项目 Pipelex/pipelex(根据 2026 年 11 月 20 日仓库公开页面快照,该项目已有 951 个 Star 与 1,880 次提交),给出了一个值得拆解的参考解法。
边界说明:本文基于
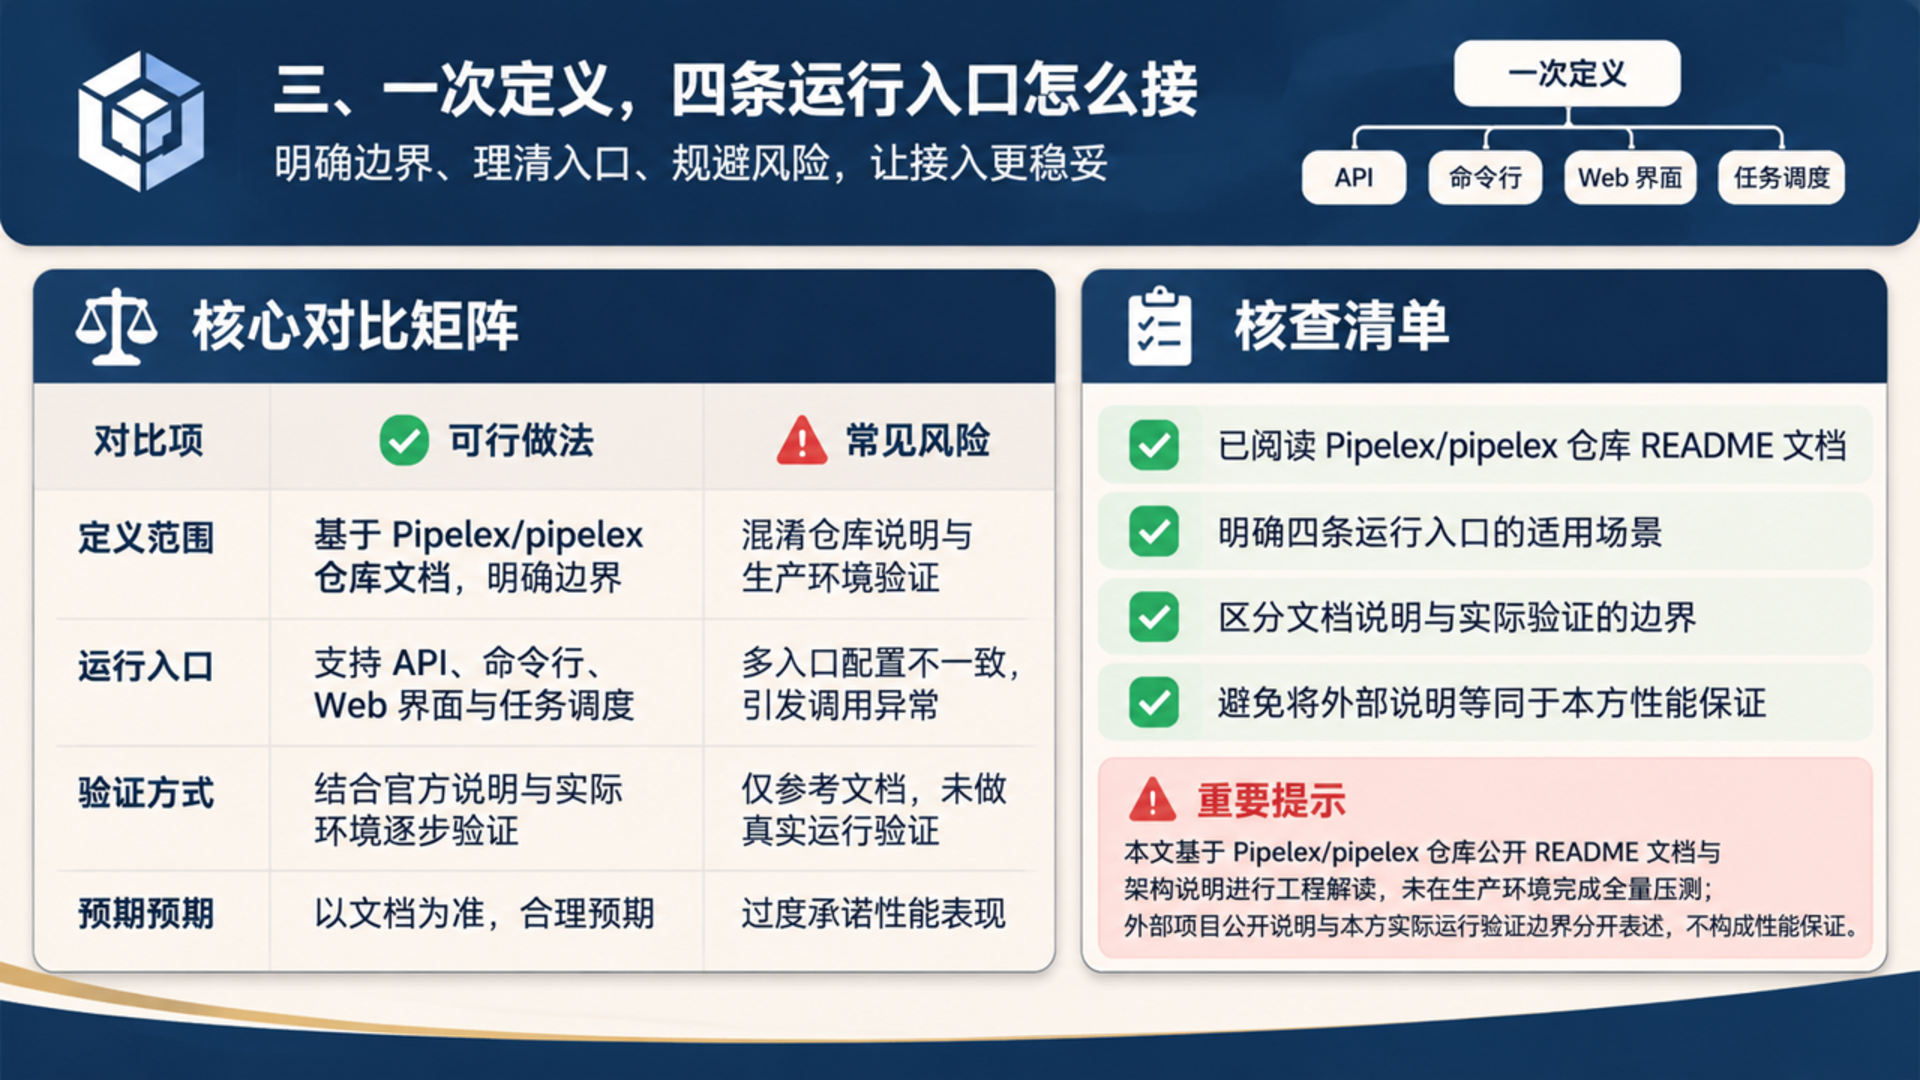
Pipelex/pipelex仓库公开 README 文档与架构说明进行工程解读,未在生产环境完成全量压测;外部项目公开说明与本方实际运行验证边界分开表述,不构成性能保证。编程助手写工作流:Pipelex如何一次定义多端运行 知
一、核心设计:先把流程写成确定的 .mthds 方法
与常见的“把一段提示词丢给自由发挥的智能体”不同,Pipelex 把核心产物定义为一个 Method(方法),底层以 .mthds 文件束形式保存。按其 README 说明,一个 Method 是由多步组成的确定性 AI 流程,可以把大语言模型文本生成、OCR 识别、图像生成等步骤串联起来。
为了降低编排门槛,Pipelex 没有要求开发者从零手写复杂的配置文件,而是把设计入口放进了 Claude Code 和 Codex 这类编程助手中:
- 安装插件而非手动搬运配置:开发者通过
claude plugin install或 Codex 插件命令加载 Pipelex 插件后,编程助手会获得创建方法、检查编辑的 Hook 校验器以及运行工具。 - 自然语言生成与逐次校验:比如用自然语言描述“读取发票 PDF 并提取供应商、总额和明细行”,
/pipelex-design会生成对应.mthds方法,编辑 Hook 会在每次改动时进行结构检查。 - 运行追踪与目录归档:通过
/pipelex-run执行任务后会返回一个run id便于回溯状态与结果文件;通过/pipelex-catalog则可以把方法保存到账户目录,供后续其他入口直接调用。
这种“让编程助手负责把确定性流程写规范,再用 Hook 守住格式边界”的做法,比单纯靠提示词临场拼接流程更容易在团队内部沉淀和复核。
二、一次定义,四条运行入口怎么接
方法写好之后,Pipelex 允许同一份定义按不同使用场景切换交付形态,不需要重写核心推理链路:
| 运行形态 | 对接方式 / 入口 | 适用对象与场景 | 文档明确提示的限制或前提 |
| — | — | — | — |
| 聊天机器人工具 | MCP 连接器(https://mcp.pipelex.com/mcp) | 在 ChatGPT、Claude 对话中直接列出并调用已保存方法 | ChatGPT 支持对话内直接上传文件;Claude 现阶段需提供 MCP 可访问的文件 URL |
| 团队 Web 应用 | /pipelex-scaffold 生成方法应用模板 | 给非技术成员使用的图形化表单或内部小工具 | 依赖模板脚手架生成本地或托管 Web 服务 |
| 业务系统集成 | /pipelex-integrate 生成 TypeScript/Python SDK 调用或 POST /v1/start | 嵌入既有后台、内容管线或 SaaS 产品 | 需处理异步任务 run id 查询与结果拉取 |
| 终端 / 自托管运行 | uv tool install "pipelex[cli]" + pipelex run bundle | 开发者终端批处理、私有化服务器或自动化脚本 | 服务端精简安装不选 cli extra 时,核心依赖 typer/instructor 仍会带入 Rich |
尤其值得留意的是它对 MCP 文件传递差异 的坦诚说明:同样接 mcp.pipelex.com/mcp,在 ChatGPT 里可以直接把附件交给方法运行,而在 Claude 侧现阶段还无法直接把对话附件转交给远端 MCP,必须传可访问的公开 URL。这类工程细节提前写明,能避免后续集成踩坑。
三、推理后端与私有化部署的取舍
对于关心数据安全、算力成本和部署可控性的技术团队来说,工作流编排工具能不能脱离单一厂商托管是关键。Pipelex 运行时提供了三种模型接入方式:
- Hosted Pipelex API:通过
pipelex init浏览器登录获取密钥,无需自己配置各家模型供应商账号即可跑通默认流程,适合快速验证原型。 - BYOK(自带密钥):按需安装对应可选依赖(如
anthropic、google、google-genai、mistralai、bedrock、fal、linkup、docling等),在本地配置文件中指向 OpenAI、Claude、Gemini 等自有账户。 - 本地模型(Local AI):支持对接 Ollama、vLLM、LM Studio 或
llama.cpp,在无外网密钥的情况下运行推理流程。
此外,如果不想使用 OpenAI 作为默认模型别名,文档也给出了在 ~/.pipelex/inference/deck/x_custom_llm_deck.toml 中覆盖 default-general 别名的配置路径。从 OpenLX 的 FDE(前置部署工程师)视角看,把“流程编排格式”与“底层模型供应商/本地推理引擎”切开,正是企业 AI 工作流从个人玩具走向可维护资产的重要前提。
四、对 AI 工作流与 GEO 工程的启发与待核验项
站在法匠科技与 OpenLX 的技术观察角度,Pipelex 这类架构至少带来两点可借鉴的工程思路:
第一,把“可复用的方法定义”当作一等公民。过去很多团队写自动化脚本,逻辑散落在网页前端、Bot 胶水代码和定时任务里。如果核心工序能抽象成带输入输出类型的确定性多步流程,后续无论是接给内部运营网页,还是作为 MCP 挂给智能助手,维护成本都会显著下降。
第二,用编辑 Hook 和诊断命令前置拦截错误。Pipelex 在插件里内置了每次编辑触发的校验 Hook,并在 CLI 提供 pipelex doctor 检查环境与后端缺口。这和严谨的发布前门禁一样,能把大量配置错误挡在正式运行之前。
当然,在决定是否引入生产链路之前,仍有几个实际问题需要进一步验证,不能仅凭仓库说明直接下结论:一是 .mthds 语法在复杂分支、人工审核暂停点与失败重试上的表达上限;二是自托管模式下同时串联 OCR(如 Docling)、文生图(如 fal)与多轮 LLM 时的并发队列和费用监控能力;三是开源许可条款及托管账户登录机制是否完全匹配特定企业的内网隔离要求。
如果团队正在梳理自己的 AI 智能体工作流或 MCP 工具封装方案,不妨先对照自身业务场景,拆解哪些步骤属于需要严格确定性的“方法层”,哪些属于可以按需替换的“交互入口层”。做好这一步分层,往往比盲目追新工具更能提升长期交付效率。
本文首发于 旅行家内容工场(https://lxjmcn.com/),转载请注明出处与完整链接。